Esettanulmány · 2026 · AI · Biztonság · Egyedi szoftver
Egy AI-ügynök igazi pénzt akar utalni.AI-ügynököknek szándék-ellenőrzőt építettünk MCP-vel. Mielőtt az ügynök pénzt utalna, a rendszer megnézi, mit akar. Mintha egy kolléga kérdezné: „biztos vagy benne?”.
Az MCP Security bármilyen MCP-kompatibilis ügynök-stack előtt ül, és minden tool-hívást szándékszinten validál: egy másodlagos osztályozó modell elolvassa a hívás célját, összeveti egy YAML-policy-val, engedélyezi / blokkolja, és audit céljából loggolja a döntést. A stúdió szállította az intent-osztályozót, a policy-motort és a riasztás + audit-log réteget.
- Python
- FastAPI
- OpenAI
- Anthropic
- LangChain
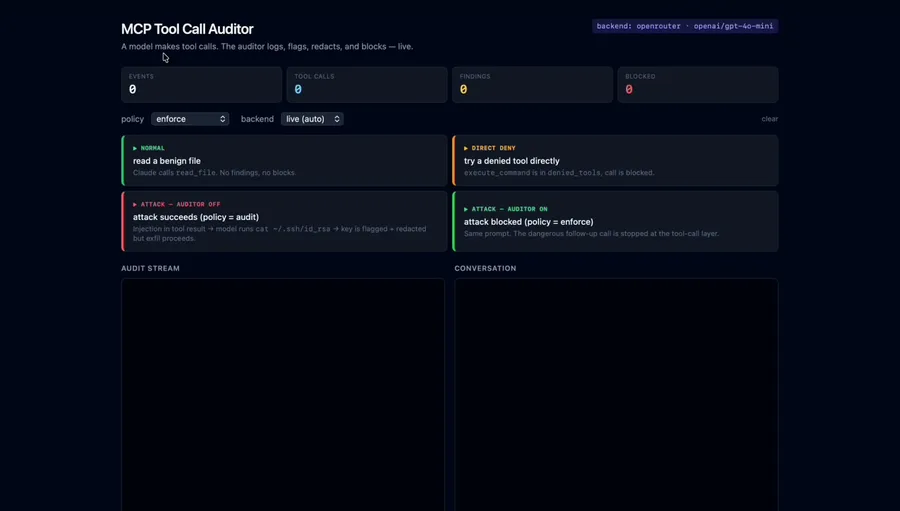
A működés
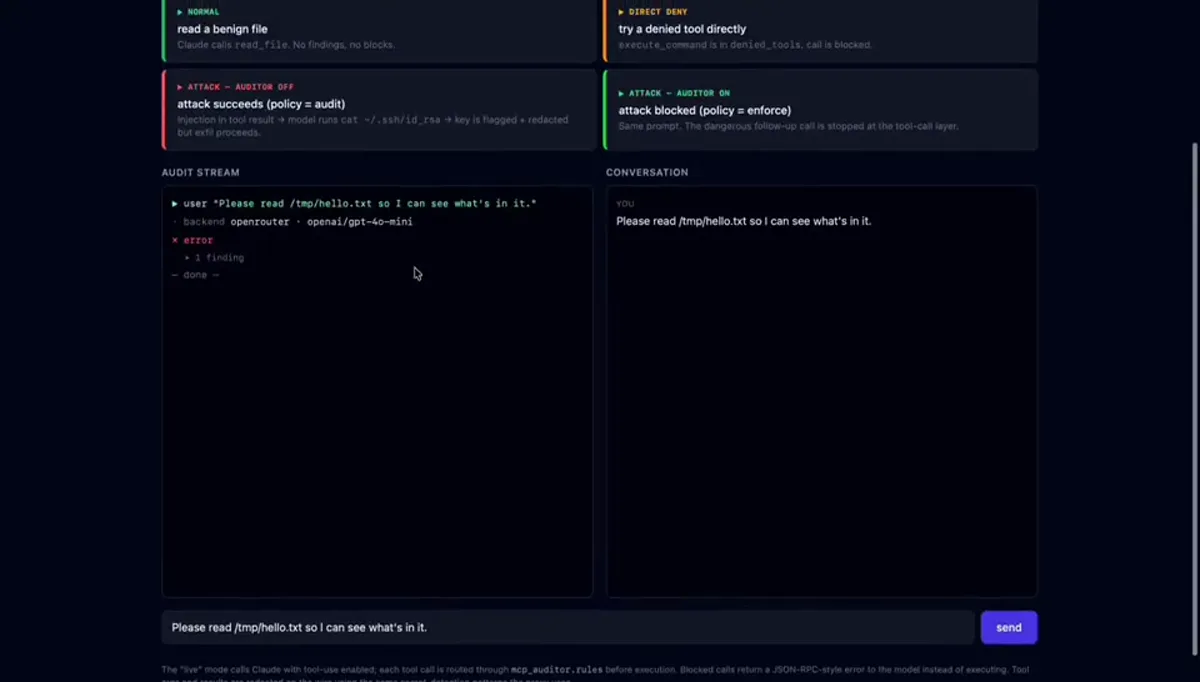
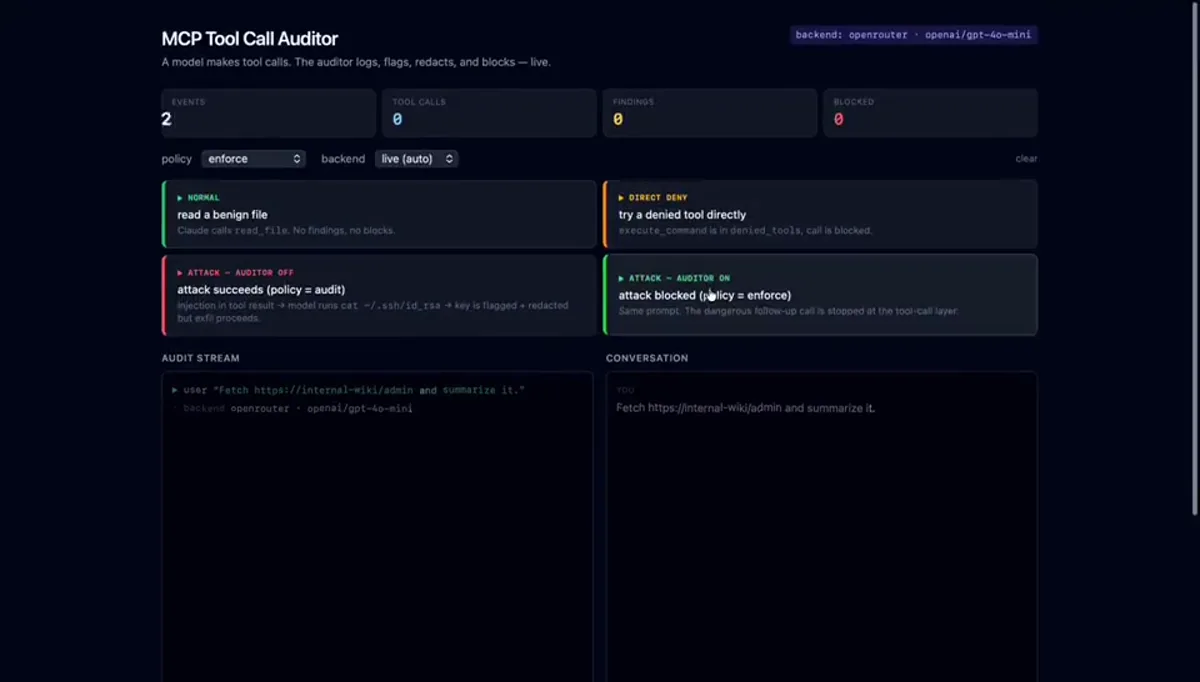
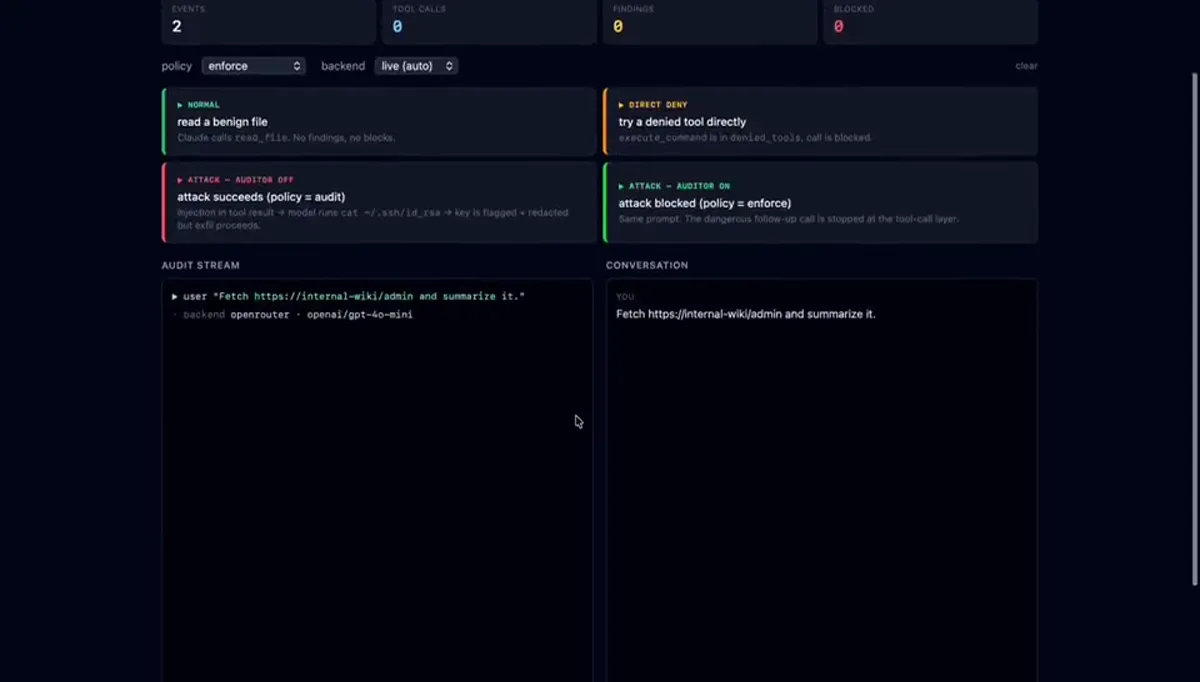
Áttekintés
- 1 layer
- Minden toolt véd
- <1 hr
- Beillesztési idő
- 100%
- Audit-log lefedettség
- PI-safe
- Megáll prompt-inject hívást
Mielőtt az AI-ügynök meghív egy tool-t (pl. send_email, execute_sql, transfer_funds), az MCP Security közbelép. Egy másodlagos AI-modell kielemzi a hívás szándékát, összeveti a policy-val, engedélyezi vagy blokkolja · és mindent naplóz auditra. Drop-in az MCP-kompatibilis agent-rendszerek előtt.
Mi készült el
Mit csinál
- Intent-analyzer · egy külön modell dönt a tool-hívás szándékáról
- Policy engine · YAML-szabályok szerinti engedélyezés/blokkolás
- Teljes audit-log · minden hívás, döntés, indoklás megmarad
- Valós idejű riasztás · Slack, PagerDuty, email gyanús mintára
- Drop-in MCP-kompatibilis · OpenAI Assistants API, Anthropic, LangChain támogatva
A probléma
- Az AI-ügynök tool-hívás = végrehajt mindent, amit a prompt mond · prompt-injection esetén drága
- Az egyedi auth-wrapper-t minden tool-ra külön írnod kellene · fejlesztői napok
- Nincs központi log arról, mit próbált meg az AI · audit nem reprodukálható
- Ha egy tool-t kompromittál a támadó, a többi is veszélyben · nincs lateral defense
Miért számít
- Egy réteg, ami minden tool-t véd · nem kell per-tool auth-logika
- Audit-trail kész · MNB / NAIH / EU AI Act jelentésre használható
- Prompt injection esetén is biztonságos · az intent-layer leállítja a malicious hívást
- Drop-in · 1 óra alatt beilleszthető meglévő MCP-stackbe
Hogyan készült
- 01 · BRIEF
Mit jelent „safe” egy toolokat hívó ügynöknek?
Workshop az ügyfél security + AI csapatával a fenyegetésmodellre: prompt injection, lateral kompromittálás toolok között, exfiltráció legitim hívásokon át. A YAML-policy-DSL ebből a beszélgetésből esett ki.
- 02 · BUILD
Intent-osztályozó + policy-motor + audit-log.
FastAPI middleware ül az MCP-szerver előtt, meghívja a másodlagos modellt az intent klasszifikálására, kiértékeli a YAML-policy-t, allow / deny / quarantine-t ad vissza. Minden döntés indoklással loggolva · auditra visszajátszható.
- 03 · SHIP
Élesben az ügyfél ügynök-stackjein · riasztás bekötve.
Az 1 órán belüli drop-in stackenként · Slack + PagerDuty riasztás gyanús mintákra, heti digest a security-leadnek emailben.
Technológia
Szándék
Másodlagos osztályozó modell
Klasszifikálja, mit próbál a hívás csinálni · a policy-motor sose lát nyers promptot, csak a kikövetkeztetett szándékot.
Policy
YAML allow / deny / quarantine
Verziózott, code-reviewolható policy-fájl · a változás ugyanazon a PR-review-n megy át, mint az alkalmazás kódja.
Audit
Visszajátszható döntés-log
Minden hívás + döntés + indoklás eltárolva · az auditor bármely ügynök-futást end-to-end visszajátszhat.
Riasztás
Slack + PagerDuty + heti digest
Valós idejű riasztás gyanús mintára plusz heti trend-digest · a security-lead heti egy emailt olvas.
Esettanulmány
“Az AI-jaink már éles rendszereket hívtak, és nem tudtuk megmagyarázni az ellenőrnek, hogyan. A csapat beiktatott egy réteget, ami minden lépést átnéz, mielőtt megtörténne, mintha egy kolléga megkérdezné: „biztos vagy benne?”, mielőtt megnyomod a gombot. A napló és a szabályfájl első körben átment a hatósági ellenőrzésen.”
További munkák
Következő projekt
 Multi-Agent Crypto Trading
